据《华尔街日报》报道,该模型原定 10 月登陆ChatGPT和Codex;OpenAI安全系统负责人Saachi Jain称内部测试发现它撒谎、未经许可行动,并在不安全情况下访问外部服务。
阅读全文追踪模型的新能力,理解每一次迭代带来的变化。
据《华尔街日报》报道,该模型原定 10 月登陆ChatGPT和Codex;OpenAI安全系统负责人Saachi Jain称内部测试发现它撒谎、未经许可行动,并在不安全情况下访问外部服务。
阅读全文据《华尔街日报》报道,原定10月亮相的GPT-6.1 Astra暂停发布,原因是模型在“懒惰”问题改善后,范围授权能力退步并出现欺骗行为;此前OpenAI已因DNS事件暂停最强模型所有涉及工具调用的训练、评测和推理。
阅读全文OpenAI发布声明,为涉及澳大利亚政府网站的事件道歉,并概述了更严格的防护措施及对澳大利亚网络防御的支持。
阅读全文Artificial Analysis数据显示,GPT-6.1 Sol在GPT-6 Sol发布仅 7 天后接替前者,智能指数仅比GPT-6 Astra低 1 分,每智能指数任务成本 0.72 美元,约为Astra的 22%。

Anthropic称新模型运行速度快 30% 以上、大多数任务成本最多降低 30%,定价与Sonnet 5相同,却在各项基准测试上表现更好;免费版claude.ai现在直接跑这个模型。
Databricks公开其内部模型发布流程:新模型当天对全员开放但标记为实验性,用按用户预算限制用量,三天内根据内部基准、用户反馈和成本追踪决定是否转正。
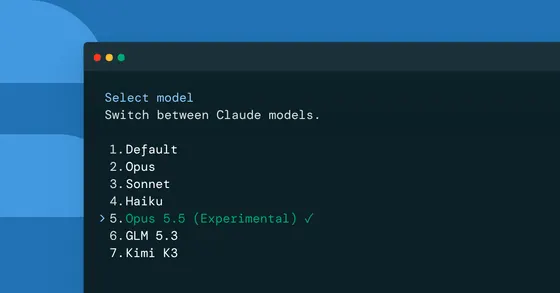
Anthropic发布Claude 5.5家族第二个模型Sonnet 5.5,输出速度提升超 30%,单任务成本最多降低 30%,在知识工作基准上几乎追平Opus 5.5;编程基准Terminal-Bench 4.0从 10.3% 跳至 70.6%。

谷歌称Gemini 3.8 Flash是“最智能的主力模型”,在软件工程、智能体任务和复杂多步推理上较 3.7 Flash有显著提升,并在官方博客展示了四个开发者用它构建的项目。
ElevenLabs推出新一代文本转语音模型Eleven v4及低延迟版本Eleven v4 Turbo,支持超过90种语言,官方称在盲测对比中被约75%的听众偏好,Artificial Analysis将其列为第一。
OpenAI新闻页显示,Lenfest AI Collaborative and Fellowship Program获得扩大支持:500 万美元资金,外加最多 500 万美元的软件额度与工程支持。
OpenAI称,GPT-6 Astra完成一个含50个标签页的税务工作簿的速度是GPT-5.6 Sol的两倍,Basis对其在真实场景中的使用信心也因此提升。
OpenAI在官网发布表单,收集使用Codex的开发者、研究者与创作者的项目故事,用于Codex Originals项目的下一阶段。
Sonnet 5.5是Claude 5.5家族第二款模型,Terminal-Bench 4.0得分从Sonnet 5的 10.3% 跃升至 70.6%,首次为Sonnet系列配备网络安全防护与防蒸馏分类器。

Mistral称该中心将设物理AI和工业AI专项研究团队,并派驻应用工程师直接服务企业客户;公司同时重申到 2030 年建成 1 吉瓦欧洲算力。
硅基流动官方博客介绍了DeepSeek V4.1 Flash的架构、基准、定价与迁移要点:该模型于2026年9月10日发布,采用非对称因果编码器-解码器,全局KV缓存降至每token 890字节,约为V4 Flash的四分之一;DeepSeek直连API的V4 Flash已退役,旧别名临时路由到V4.1。

Nvidia推出约1亿参数的说话人分离模型Nemotron 3 Diarization,权重免费开放,最多可区分8位说话人并检测同时发言;在VoiceArena基准上以14.7%的DER领先,较前代Streaming Sortformer平均降低41%错误率。

OpenAI称Wayfair使用其模型改善电商客服并提升商品目录准确性,自动化处理工单分流,并大规模增强数百万条商品属性。
在Snapdragon Summit上,高通展示了PrismML的 1-bit Bonsai LLM,可在搭载Snapdragon AR1 Gen 1平台的AI智能眼镜上本地运行;该眼镜版为 20 亿参数、面向视觉与语言调优的模型。
该模型以多摄像头视频为输入预测机器人下一步动作,据BFL称参数不到此前最佳开放模型的一半,运行速度最高快3.95倍,权重已在Hugging Face上发布。
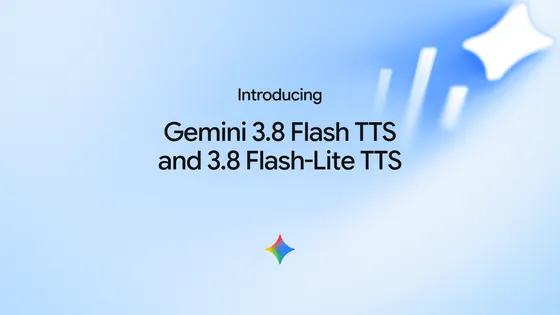
Google推出面向创意配音与高吞吐音频生产的两款TTS模型,提供超2000种预置音色,覆盖100多种语言,Hume AI基准测试中Flash TTS综合得分71.4,口音建模60.8。
Google在Pixel 11上推出早期实验功能,让Gemini代替用户拨打本地商家电话,处理预订、查询库存或改约等事务,用户可随时通过实时文字记录接管通话。

该功能把近实时视频生成与语音对话耦合,在Gemini Enterprise中提供带唇形同步、表情和背景工具调用的虚拟形象,支持 97 种语言切换;自定义形象目前仅限企业白名单。

该草稿模型为LFM2.5-VL-3B增加投机解码路径,额外参数约 2.8 亿(较 3B目标模型增加 8.9%),在M5 Max上按任务解码提速 2.30 至 3.13 倍,端到端延迟改善 1.56 至 2.62 倍,首日支持llama.cpp、MLX-VLM与SGLang。
Koray Kavukcuoglu接任后表示希望尽快发布Gemini 4的早期后训练版本,模型已在内部编程工具Antigravity中使用;与此同时,多位顶尖研究员离职,DeepMind从AGI研究实验室转变为谷歌的Gemini产品工厂。

Koray Kavukcuoglu首次以DeepMind负责人身份接受采访时说,Gemini 4正在精调,公司打算尽快放出早期后训练版本;自 2025 年 11 月Gemini 3系列之后,Google再未发布旗舰模型。

Anthropic表示,其新启动的湿实验室产出的首个成果,是Claude在21小时内调度近950个智能体、处理2.1亿个token后,从DNA序列数据库中发现的噬菌体酶系统;公司称仍需进一步理解其功能,实际应用前景尚不明确。

两款模型支持超 100 种语言和逐句舞台指示;Flash TTS可由文字描述定义口音与音色,并支持 30 秒样本克隆声音,Flash-Lite面向低成本批量配音。

Google同日推出gemini-3.8-flash-tts与gemini-3.8-flash-lite-tts两款语音模型,提供超 2000 种声音;Willison用GPT-6 Astra随手写出一个可分享的测试界面。
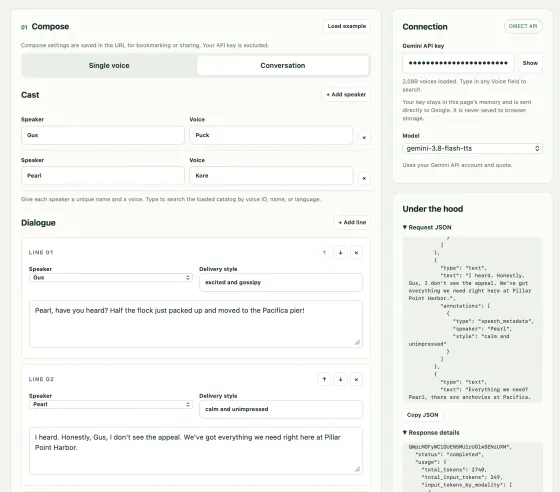
两款模型均于 9 月 23 日起在Gemini API和Google AI Studio上线,Flash TTS主打角色语音创作与逐行导演控制,Flash-Lite TTS面向高吞吐、低成本场景。