
更新日志显示,v0.41.0加入ImageSDRToHDR与ReferenceMultiLatent节点、Latent几何获取节点,支持MiniMax-H3 LightVAE与Flux3-image模型,工作流模板同步升至v0.11.84。
阅读全文开源项目
关注开放的模型、工具与代码,找到值得动手的项目。
本页最新按事件时间排序

IBM发布Granite Switch 4.1:单个端点整合聊天、决策与语音转写
IBM在Hugging Face博客称,Granite-Switch-4.1-8B和 -30B将通用决策aLoRA、Guardian安全决策aLoRA与Granite-Speech-5.0-Turbo-CTC组合进一个模型,显存占用与基础模型单独运行时大致相当。
阅读全文
Anthropic Python SDK发布v1.15.0:Messages新增speed参数与usage.speed字段
该版本在API侧加入speed参数及对应的usage.speed用量字段,返回Console组织usage-tier支出上限为只读spend limit,thinking类型新增between_tools,并在文档中提示部分模型使用speed需beta头。
阅读全文
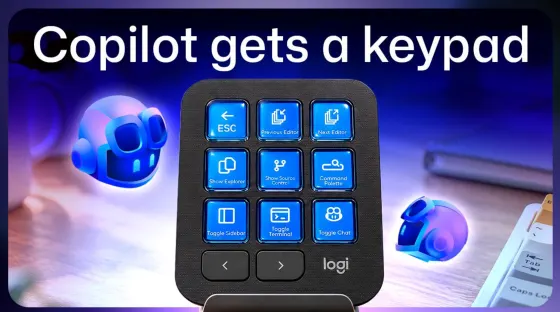
GitHub与Logitech合作:MX Keypad可一键触发Copilot代理工作流
GitHub开发者关系副总裁Martin Woodward在官方博客宣布,GitHub与Logitech合作将GitHub Copilot应用集成到MX Keypad硬件中,开发者可将重复提示、启动/恢复Copilot会话或触发多步序列映射到实体按键。
LangChain发布langchain-core 1.6.11,LangChainTracer支持传入address
本次版本在langchain-core 1.6.10基础上包含两项改动:版本号更新至 1.6.11,以及LangChainTracer新增接受address参数的能力。
Hugging Face Transformers v5.20.0发布:新增 7 个模型,导出器支持量化
该版本加入Meta的Muse Spark Open、InclusionAI的Ling 3.0 Flash、Aleph Alpha的Kolibri 1等模型,并移除已弃用的缓存方法与跨模型导入,最低kernels版本升至 0.17.2。

llama.cpp发布v0.7.0,新增Nemotron Super 3.5 VL等模型支持
ggml-org项目llama.cpp从v0.6.0升到v0.7.0,同时将ggml升至 0.27.0;更新日志列出模型支持、服务端与各后端修复等大量改动。
llama.cpp发布b11669,版本号升至 0.7.0
该版本由llama.cpp仓库自动发布流程生成,构建号b11669,主要变更标注为将版本提升至 0.7.0(PR #30603),并附带覆盖多平台的预编译产物。
llama.cpp发布b11662构建版,同步ggml;openEuler构建与KleidiAI macOS版被禁用
llama.cpp的b11662版本按macOS/iOS、Linux、Android、Windows、openEuler和UI分类提供预编译包,更新内容标注为“sync : ggml”,另有两处平台构建被标注DISABLED。

LiteLLM发布v1.106.0-rc.4,回移 5 项decisions改动
该预发布版本由机器人提交,将 #45474、#45811、#45734、#46594、#46596 五个PR回移至rc/1.106.0分支;发布说明同时重申Docker镜像的cosign签名验证方法。
llama.cpp b11655修复Vulkan并发首次设备初始化崩溃
llama.cpp发布b11655版本,修复Vulkan后端并发首次设备初始化问题,并调整线程安全测试为并行加载模型,以暴露此前被串行加载掩盖的崩溃。
llama.cpp b11647为AMD端Vulkan后端增加f16/bf16 KV跨步拷贝
该版本在AMD上把跨步的f16 KV先拷贝到scratch,使跨步访问落在顺序写入上,避免读取集中到少数内存通道;同一改动后续扩展到bf16,并在RDNA4上禁用。
llama.cpp b11645为Metal张量API闪存注意力内核增加BF16变体
该版本发布说明显示,Metal后端新增了张量API flash attention内核的BF16变体(#30491),并把张量FA内核移动到kernels/fa_tensor.metal。
Apertus 1.5发布:8B与 70B模型新增图像音频理解,上下文扩至 262k
瑞士AI计划将Apertus 1.5的 8B和 70B权重于 2026 年 7 月 24 日发布到Hugging Face,采用Apache 2.0许可;模型新增原生多模态理解、可选思考模式和 26.2 万token上下文窗口。
蚂蚁百灵开源Ling-3.1-flash:560B总参数、25B激活,主打真实工作流
量子位报道称,蚂蚁百灵推出开源模型Ling-3.1-flash,定位“高智效比专业模型”,已接入蚂蚁内部桌面协同Agent客户端“小虎”,官方给出的办公任务评测ELO为1673,Artificial Analysis评测智能指数41、输出速度约210 Token/秒、混合调用价格约每百万Token 0.19美元。
llama.cpp b11641发布:新增lilicorr支持
llama.cpp发布b11641版本,主要变更为spec模块加入lilicorr支持(PR #30506),由Georgi Gerganov共同署名。版本同时提供多平台预编译包。
LiteLLM发布v1.107.0-dev.2,含多项代理、路由与Anthropic修复
该开发版本更新了Docker镜像签名验证说明,并合入数十项功能与修复,涉及proxy权限范围、Anthropic桥接、Redis超时与成本映射等。
llama.cpp b11640发布:Vulkan后端为cm2 mulmat改用L2友好工作组调度
该版本唯一列出的代码变更是针对Vulkan后端的cm2 mulmat工作组调度调整(PR #30215);发布页同时提供各平台二进制,包括新增或更新的CUDA 13.4、ROCm 10.0、OpenVINO 2026.4.1等构建。
llama.cpp b11636为SYCL后端加入IQ3权重持久重排,Intel Arc上token生成最高提升 82%
该版本在SYCL后端为IQ3_S与IQ3_XXS量化权重加入加载时持久重排,避免了推理时从交错布局中逐位收集;发布说明给出的Intel Arc Pro B70实测显示,token生成速度随上下文长度提升 53% 至 82%,而标准量化模型变化在噪声范围内。
llama.cpp b11635回退x86 FP16→FP32的F16C路径,恢复查找表以避开内核减速
llama.cpp发布构建b11635,其中ggml-cpu在x86上重新对FP16→FP32转换使用查找表,仅保留FP32→FP16走F16C。提交信息称,Clang 20.1.8会把该intrinsic降级为并入累加器寄存器的vpinsrw,串行化循环,实测Q8_0/Q4_0 MUL_MAT_ID内核慢 45%–65%。
llama.cpp b11633修复ggml-cpu SET_ROWS多线程缓冲区越界
该版本修复了SET_ROWS在多线程CPU推理图里越界写入F16→F32转换缓冲区的问题,并随版本提供各平台预编译包。
llama.cpp发布b11627:为mul_mat_id补充说明并禁用mul_mat_id_dup测试
该版本在ggml层为mul_mat_id增加了一处说明,并关闭了mul_mat_id_dup相关测试(PR #30501);同时照常提供各平台预编译包。
Meta发布Muse Spark Open:816B参数开源多模态MoE模型,约 42B激活
Hugging Face博客介绍Meta新开源权重模型Muse Spark Open,总参数约 8160 亿、每token激活约 420 亿,支持文本、图像、音频、视频输入,上下文窗口最高 100 万token,面向智能体编程场景训练。
Black Forest Labs发布FLUX.3 Image Klein:单模型支持布局控制,Diffusers首日接入
Hugging Face博客称,FLUX.3 Image Klein同日上线Diffusers,一个模型同时处理文生图、多参考图生图与边界框布局控制;蒸馏检查点默认 16 步生成 1024×1024 图像,H100上约 2 秒。
python-genai发布v2.31.0:Model枚举新增gemini-4-argon,修复多处长时续写问题
Google的python-genai客户端库于 2026-10-14 发布 2.31.0 版本,新增gemini-4-argon模型枚举值,并集中修复自动续写、函数声明解析和mTLS端点的四个缺陷。
LiteLLM发布v1.106.0-rc.3:回移guardrails与Prometheus修复
该候选版本将两个修复回移到rc/1.106.0分支,发布说明同时给出用cosign校验Docker镜像签名的两种方式。
Open WebUI v0.12.2发布:支持自托管MinerU 4.x,修复SCIM删除管理员等安全问题
该版本让MinerU文档引擎兼容自托管 4.x服务器(此前每份文档因接口移除返回 404),并新增自定义请求头 {{MODEL_ID}}、审计日志model_id字段、Milvus自定义TLS证书等能力,同时修复了频道消息元数据可伪造、SCIM可删除管理员等缺陷。
llama.cpp b11623发布:AMD平台改用SIMT隐式GEMM conv2d,绕过WMMA
llama.cpp发布b11623构建版,CUDA后端针对AMD设备改用不依赖WMMA的SIMT隐式GEMM conv2d,并在短归约场景下跳过该实现。
Ollama发布v0.40.5-rc0:为CUDA移植Metal自定义内核
该候选版本包含五项变更,其中mlx的Metal自定义内核被移植到CUDA;同时OpenAI兼容层开始接受Responses历史中的自定义工具调用。
llama.cpp b11622修复Jinja tojson浮点输出,改为与Python一致
该版本将tojson的浮点数输出从C++流的 6 位有效数字改为按json.dumps规则写最短可还原数字,涉及工具定义、工具调用参数及其他模板输出。