

该版本通过将hrm_text固件改为两个l-cycle,使fp16误差减半,重新低于 1e-4 NMSE阈值,修复Models Backend Check在Vulkan T4和WebGPU任务上的失败。
阅读全文开源项目
关注开放的模型、工具与代码,找到值得动手的项目。
本页最新按事件时间排序

Anthropic Python SDK发布v1.10.0:Admin API新增企业分析、消费限额与插件市场
该版本把Claude Enterprise的分析、支出限额和RBAC群组角色加入Admin API,并新增按用户的使用与成本报告、插件及插件市场接口;Organization API端点转为正式可用。
阅读全文llama.cpp发布b11294,新增llama_prefetch_rows行预取并登陆Windows
该版本引入llama_prefetch_rows行预取功能,由Pranesh Gonegandla贡献的Windows移植版被原样合并;预取仅在lazy模式下启用,并通过llama-impl路由避免在模型代码中暴露llama-mmap。
阅读全文llama.cpp b11293为ggml新增BF16一元、GLU、二元与缩放算子(CPU、CUDA)
该版本在ggml层加入BF16一元、GLU、二元和scale运算的CPU与CUDA实现,并修复HIP bf16构建;ggml-openvino后端明确拒绝BF16 SCALE与混合类型BF16 ADD/MUL/SUB。
Hugging Face Transformers 5.18.0新增Nemotron 3说话人分离等四个模型
Nemotron 3 Diarization支持流式与离线说话人分离,最多处理 8 人;NemotronH Omni把文本、图像、视频和声音放进同一个自回归模型。
llama.cpp b11292发布:CPU后端接受mul_mat的BF16 src1,Vulkan收紧支持条件
llama.cpp新构建版本b11292的更新说明显示,CPU后端开始接受mul_mat中src1为BF16的输入组合,Vulkan后端则拒绝该组合(除非src0也是BF16),并补充了conv_1d_dw与mul_mat测试。
LangChain发布langchain-openai 1.6.7,新增Azure工作负载身份发现
该版本新增Azure工作负载身份发现功能,刷新了模型配置数据,并移除了已停用的补全接口实时测试。

DeepSeek开源华为昇腾芯片编程工具,核心是TileLang
DeepSeek与华为联合发布面向昇腾芯片的开源编程工具,包含计算与芯片间数据传输库,并优化了 128 颗昇腾 950 芯片组成的超节点;核心语言TileLang源自北京大学研究者的工作。
llama.cpp b11284修复OpenVINO对量化权重视图执行GET_ROWS的限制
该版本让量化权重上的视图解析到基础Constant,并把行偏移折叠进gather索引,从而解除此前对带非零偏移的量化src0视图的supports_op拒绝。
llama.cpp b11282修复MUSA后端架构宏缺失,摩尔线程GPU内核不再被编译为空
MUSA厂商头文件从未定义 __CUDA_ARCH__,导致共享ggml-cuda源码里所有架构判断都取值为 0,按架构门控的内核被编译成空;b11282参考HIP后端的做法补上该宏。
llama.cpp发布b11280:SYCL后端用固定主机缓冲减少张量allreduce同步
该版本由GitHub Actions机器人发布,唯一说明的代码改动是SYCL后端PR #29604;同时提供覆盖macOS、Linux、Windows、Android的预编译包,多个后端或平台处于禁用状态。
Anthropic称智谱开源模型GLM-5.3构建漏洞利用能力接近Claude Mythos Preview
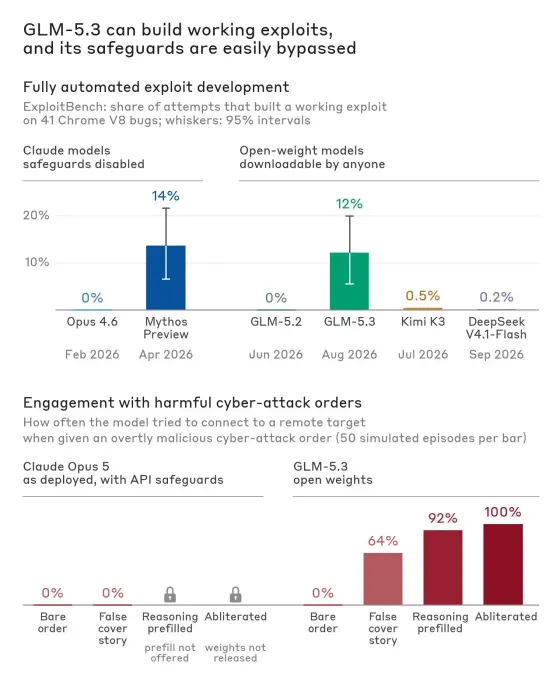
Anthropic公布测试数据:GLM-5.3在410次尝试中50次成功构建Chrome V8引擎漏洞利用,Mythos Preview为56次;其防护措施易于绕过,去除拒答能力的版本已在模型发布后数天内流传。
llama.cpp b11279加入GLM-5.3-Flash(GLM5-Next)支持
合并请求 #27773 为llama.cpp引入GLM-5.3-Flash架构支持,包含多流预取、k-pool缓存复用与混合状态回滚修复,同时发布覆盖macOS、Linux、Windows、Android的新版二进制。
llama.cpp发布b11278版本:更新BoringSSL并重建全平台预编译包
这次发布的主要内容是把BoringSSL升级到 0.20260929.0(PR #29669),同时按惯例为macOS、Linux、Windows、Android等平台重新打包了预编译二进制。
llama.cpp b11277发布:为ggml-zdnn后端实现缓冲区重置并修复内存泄漏
该版本的主要代码变更来自PR #29637,为IBM zDNN后端实现缓冲区重置、修复内存泄漏,作者Aaron Teo同时修正了代码风格。
llama.cpp b11276为Hexagon后端加入F16激活算子支持
该版本把SILU、GELU、GELU_QUICK、GEGLU、SWIGLU的F16激活算子搬到Hexagon DSP上,其中前五个已在QRD8850上通过CPU对比校验,SWIGLU_OAI只完成代码尚未验证。
llama.cpp b11275修复GGUF张量填充溢出绕过大小校验的问题
当张量字节数落在SIZE_MAX减去对齐值加 1 的窗口内时,GGML_PAD会把数值回绕成 0,从而悄悄跳过了gguf_init_from_reader中的尺寸溢出检查;b11275在填充前先拒绝这类张量。
llama.cpp b11273支持ModernBERT重排模型使用classifier_pooling
该版本允许配置classifier.pooling_type,ModernBERT未指定时回退到mean,转换脚本只接受cls和mean两种取值。
llama.cpp b11270:HIP后端用 __vsub4优化打包字节减法
llama.cpp发布b11270构建,改动集中在ggml-cuda的HIP路径:把非饱和打包字节减法从 __vsubss4换成 __vsub4,并在CI中忽略fattn_vec的 1 个溢出vgpr。
DeepSeek开源昇腾基础设施组件,含TileLang编译工具与DeepEP通信库
9月30日,DeepSeek面向华为昇腾平台开源DeepGEMM、FlashMLA、TileKernel、DeepSelect等高性能算子库及DeepEP分布式通信库,与此前GPU平台开源组件一一对应;华为同步在CANN社区开源大EP低延时推理、单卡/单机部署等联合创新成果。

LiteLLM发布v1.104.0-rc.2,说明Docker镜像cosign签名校验方式
该预发布版发布说明未列具体代码改动,只给出了用固定commit哈希或release标签验证ghcr.io镜像签名的两条cosign命令。
LiteLLM发布v1.103.1,并说明Docker镜像的cosign验证方式
LiteLLM发布v1.103.1,所有LiteLLM Docker镜像均使用cosign签名,发布说明给出了用固定commit哈希和发布标签两种验证方式及预期输出。
LiteLLM发布v1.101.3,强调用cosign校验Docker镜像签名
LiteLLM v1.101.3的发布说明没有列出功能改动,只给出Docker镜像的cosign签名校验方式,并推荐用固定的commit哈希而非发布标签来获取公钥。
LiteLLM发布v1.100.4,所有Docker镜像用cosign签名
LiteLLM v1.100.4发布,版本更新本身没有列出变更条目,发布说明主要交代了Docker镜像的cosign签名验证方式:官方推荐用固定commit hash验证,也可以用release tag验证。
llama.cpp发布b11268:修复Adreno OpenCL下q5_K的get_tensor
该版本的核心改动是给OpenCL后端补上q5_K量化在Adreno gemm_nonshuffle内核上的张量读取修复,同时照例放出覆盖macOS、Linux、Windows、Android的多平台预编译包。

OpenAI Python SDK发布v3.22.1,修复缺失认证错误信息等两项问题
该版本于 2026 年 9 月 30 日发布,包含两项Bug修复、一项测试调整和两处示例文档更新。
llama.cpp发布b11267:调整Vulkan GDN内核并修复Intel性能
该版本的主要代码变更是Vulkan后端:调优GDN着色器,并针对Intel平台修复性能问题(PR #29476)。发布页同时提供macOS、Linux、Windows、Android等多平台预编译包。
OpenAI Codex发布 0.159.2 修复Windows控制台窗口闪烁
该版本仅包含一项修复:当Codex启动后台进程和沙箱命令时,Windows上不再闪现控制台窗口,改动通过 #49385 回移至 0.159 分支。
llama.cpp b11265修复Vulkan MoE矩阵乘法瓦片选择
llama.cpp发布b11265版本,修复Vulkan后端在MoE分发网格中按总token数而非每专家行数选择matmul瓦片的问题;在Sarvam 30B、pp128场景下真实N为 6 而非 128,导致多数worker空转,慢速部分占整体任务 55%。