
该版本自 1.6.5 起包含两项改动:发布 1.6.6 版本,并修复当流式路径中出现错误事件时未抛出异常的问题。
阅读全文开源项目
关注开放的模型、工具与代码,找到值得动手的项目。
本页最新按事件时间排序

llama.cpp b11157为CUDA后端加入conv3d隐式GEMM
该版本的核心改动是在CUDA后端新增conv3d的隐式GEMM实现,并细化该实现、处理空内核;同时释出覆盖macOS、Linux、Windows、Android与Snapdragon的多平台预编译包。
阅读全文llama.cpp b11156发布:新增Ling 3.0 VL多模态模型支持
本次提交 (#29151) 将Ling 3.0 VL并入BailingMoeV3架构,并修复了mrope门控下共享NORM rope列表的完整性问题。
阅读全文llama.cpp发布b11155:再次修复GCC 12的stringop-overread误报
该版本标题为「server,common : fix the GCC 12 stringop-overread false positive (again)」,由Adrien Gallouët提交(#29325),同时照例附带各平台预编译二进制。
llama.cpp发布b11153:Hexagon后端拒绝F32精度的MUL_MAT_ID
llama.cpp构建版本b11153发布,唯一列出的改动是在Hexagon后端中,当src1精度为F32时拒绝MUL_MAT_ID操作(PR #29348)。
gemini-cli发布v0.62.0夜间版,修复连接恢复重试提示
该夜间构建包含两项改动:运行VSC集成测试前先检查其是否存在,以及在连接恢复期间显示重试进度指示器。

LiteLLM发布v1.101.2,Docker镜像可用cosign验签
LiteLLM的Docker镜像统一使用同一把cosign密钥签名,官方推荐用固定提交哈希验证,也可用发布标签验证。

openai-python发布v3.19.2:修复回退提取路径丢失单文件问题
OpenAI Python SDK在 2026 年 9 月 23 日发布 3.19.2 补丁版本,修复一个回退提取路径下文件保留的bug,并同步澄清Web搜索位置默认值、Realtime模态数组定义等API文档措辞。
gemini-cli发布v0.61.0,修复间接提示注入与沙箱文件系统边界
该版本包含一项修复:阻止通过构建文件修改和不可信标志触发的间接提示注入;另一项修复用于加固沙箱文件系统边界并隔离运行时状态。
gemini-cli发布v0.62.0-preview.0,修复PTY生命周期与OAuth凭证问题
这一预览版以修复为主:涉及A2A服务端、核心PTY清理、OAuth刷新令牌保留、终端渲染内存管理等,同时包含一项Gemini 3.8 Flash / 3.5 Flash Lite相关改动。
NVIDIA发布NV-Reason-CT:首个面向3D CT的开源思维链视觉语言模型
NVIDIA推出专为3D CT分析构建的视觉语言模型NV-Reason-CT,在CT-RATE基准上以原生3D生成式架构取得0.614宏F1和0.871宏AUROC,首次让单一开源模型同时具备CT分类与报告生成能力。模型以研究基础定位发布,非获批临床产品。

gemini-cli发布v0.61.0-preview.1,仅含一次补丁迁移
该预览版本通过cherry-pick提交 62364cb到v0.61.0-preview.0的发布分支生成,对应PR #29455。
llama.cpp b11149发布:test-llama-archs新增 -b/--backend选项
llama.cpp发布b11149版本,核心改动是给测试工具test-llama-archs加上 -b/--backend参数,可指定单一后端跑架构测试;同版本照例附带全平台预编译二进制。
llama.cpp发布v0.5.0:新增HRM-Text等模型支持,服务器可绑定多地址
该版本同步ggml 0.25.0,为CUDA conv2d、Metal MoE与SSM_CONV带来性能优化,并修复路由竞争、聊天解析器与多模态检查等问题。
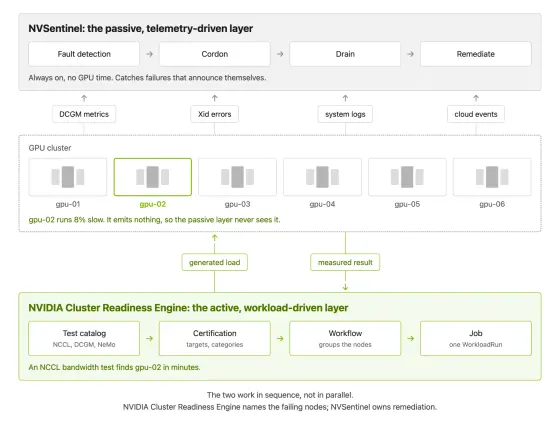
NVIDIA开源NVCRE:上生产前先在Kubernetes上跑真实分布式负载验证GPU集群
NVIDIA发布开源Kubernetes控制器Cluster Readiness Engine,通过拓扑感知节点组跑真实NCCL、DCGM和NeMo工作负载,报告是哪块节点失败,而不是等 512 卡训练跑几小时后才发现问题。

Claude Code v2.1.281发布:新增Bedrock角色扮演与护栏、隐藏提交归因,修复大量会话恢复与流式传输问题
该版本为Claude apps gateway加入Bedrock的assume_role与guardrail支持、settings.json可关闭commit/PR归因,并集中修复了恢复会话丢历史、代理截断流被当成完整响应等数十个问题。
OpenAI Python SDK发布v3.19.1,修复工具迭代器与HTTP头合并问题
该版本于 2026-09-23 发布,包含两项Bug修复、一项API说明澄清和一项文档更新。

NVIDIA详解MuJoCo Warp:把SO-101机械臂仿真扩展到 2048 个并行环境
Hugging Face博客发布NVIDIA撰写的教程,介绍如何把经典MuJoCo场景迁移到基于Warp的MJWarp,让同一套MJCF模型在GPU上批量推进,最多同时运行 2048 个独立仿真世界。
GitHub重建Copilot应用PR视图,2200 文件百万行diff可流畅滚动
GitHub官方博客介绍,团队用两套几何体系与惰性测量调度器重写拉取请求视图,并用自主循环自动定位性能bug。
Black Forest Labs发布FLUX 3 Action:7B开源世界动作模型登顶RoboLab
FLUX 3 Action(F3A)以 38.3% 的成功率在RoboLab基准上超越Cosmos 3 Nano的 36.8%,同时通过引导蒸馏将采样步数压缩到单步,推理速度较Pi0.5提升 1.34 至 2.28 倍。
LangChain发布langchain-anthropic 1.7.4:支持对话中通过SystemMessage更换工具
该版本在anthropic与openai集成中新增“对话中途更换工具”能力,并为Opus 5.5和GPT-6增加profile增强,同时修复了集成测试磁带。
llama.cpp b11140为dsv4预填充重新启用CUDA稀疏注意力
这次更新让flash_attn_mask_to_sparse_indices内核在编译期确定循环边界,稀疏掩码扫描从 46 微秒降到 17 微秒,批量稀疏算子从 586 微秒降到 244 微秒(49k上下文)。
llama.cpp发布b11139,修复休眠时token计数API崩溃
该版本合并PR #29309,修复server在休眠状态下被唤醒时token计数API崩溃的问题,同时按平台提供macOS、Linux、Windows、Android等预编译包。
LangChain发布langchain-openai 1.6.5,新增对话中修改工具与模型档案增强
该版本相对 1.6.4 更新三项内容:OpenAI包升至 1.6.5,为Anthropic补充Opus 5.5与GPT-6的profile增强,并支持在SystemMessage中于对话中途变更工具。
llama.cpp b11136让llama-server兼容OpenAI的video_url视频输入
llama-server此前只认非标准的input_video类型并拒绝data: 视频URI,符合OpenAI规范的客户端会被报“unsupported content[].type”或“Invalid uri format”;b11136把video_url作为input_video的别名接受,并放行data:video/* URI。
llama.cpp b11132支持Gemma 4 DSpark草稿骨干
该版本为全注意力和SWA两种Gemma 4 DSpark草稿加入GGUF转换与运行时支持,并处理绑定输出权重和布尔型骨干元数据。
NVIDIA发布Nemotron 3 Diarization:1 亿参数开源模型,8 人说话人日志DER 14.72% 登顶VoiceArena
NVIDIA在Hugging Face博客发布开源权重说话人日志模型Nemotron 3 Diarization,支持最多 8 人、实时与离线两种模式,在VoiceArena首批Diarization-Bench中 12 个系统里排名第一。
llama.cpp发布b11130构建,同步更新摘要提示词
本次更新由自动发布流程打包,覆盖macOS、iOS、Linux、Android、Windows等平台的CPU、CUDA、Vulkan、ROCm、SYCL、OpenVINO等多种后端。
llama.cpp b11124发布:修复CUDA后端top-k MoE触发问题
该版本的主要代码变更是让CUDA后端的top-k MoE路由“始终触发”,同时按平台更新了macOS、Linux、Windows、Android等预编译包。