

llama.cpp的GitHub发布页显示,b11792版本包含一项llama相关改动(#30912),将d2t放到其set_rows使用处,以便它继续留在GPU上;同一发布页列出了各平台预编译包。
阅读全文开源项目
关注开放的模型、工具与代码,找到值得动手的项目。
本页最新按事件时间排序

英伟达在Hugging Face发布SimReady Central:2000 余个仿真就绪OpenUSD资产免费开放
英伟达博客称,SimReady Central Library已在Hugging Face上线,汇集 2000 多个自带碰撞几何、质量、摩擦等仿真属性的OpenUSD资产,开发者可免费、无需审批地用于机器人训练环境与AI工厂数字孪生。
阅读全文
LiteLLM发布v1.106.2:为稳定分支回移批量成本与代理支出修复
该版本把三项修复回移到stable/1.106.x,分别涉及Bedrock Mantle的 404 回退、batches的成本与定价及翻译问题、proxy的支出与成本问题;发布说明同时给出用cosign校验镜像签名的两种方式。
阅读全文llama.cpp发布b11790:Hexagon后端加入NEON向量化与分块线程重打包
该版本提交说明称,为Hexagon的repack(重打包)加入NEON向量化,覆盖q4_0及q1/q2/f16等类型,并加入简单的分块与线程处理;发布页同时列出Snapdragon的Linux与Android构建包。
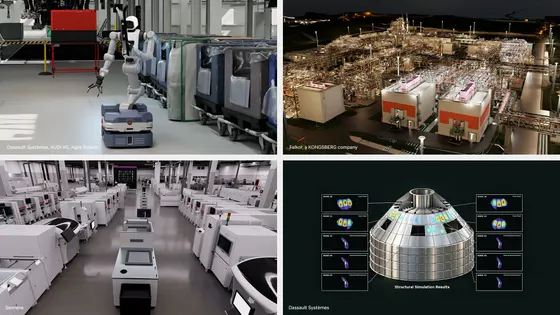
英伟达在GitHub开放工厂运营蓝图FOX早期访问,西门子称用于排障可省 20% 成本
英伟达称,Factory Operations Blueprint(FOX)已在GitHub开放早期访问,供开发者构建面向工厂的“常驻经理型”智能体和视觉检测、根因分析等专项智能体;西门子正把基于FOX构建的智能体整合进Intelligence Center X,并称预计可节省 20% 成本。
llama.cpp b11789发布:OpenCL后端为GEMM增加dp4a变体
该版本发布说明显示,本次改动在OpenCL后端为GEMM增加dp4a变体并采用向量化的激活加载,同时重命名了相关kernel和env vars;其余内容为各平台预编译产物的更新。
llama.cpp发布b11788,修复SYCL后端注意力计算崩溃
该版本变更说明只有一条:SYCL后端在Query头维度与HSK不匹配(neq0 != HSK / D=2048/4096)时,修复flash attention路径的崩溃;其余内容为各平台预编译包的下载清单。
LiteLLM发布v1.105.3,向 1.105.x稳定分支回移多项修复
该版本将MCP按用户鉴权工具列表、Bedrock Mantle count_tokens回退、计费修复及批处理成本与定价修复回移至stable/1.105.x,并附cosign镜像签名验证方式。
llama.cpp发布b11787,合并SYCL mmq启动路径重复代码
该版本唯一列出的代码变更是sycl后端mmq中合并重复的need_check启动函数体(#30739);发布页同时提供macOS、Linux、Windows、Android等多平台预编译包。
LiteLLM发布v1.103.7,修复Batches计费与Bedrock token计数回退
该版本为stable/1.103.x分支的backport,包含三项修复:Bedrock Mantle count_tokens回退、LIT-145花费追踪修复,以及Batches的P0成本、定价与转换修复;官方同时说明Docker镜像签名验证方式。
llama.cpp b11786:CPU后端改用无FP16查表方式计算f32 gelu_quick与geglu_quick
llama.cpp发布b11786版本,ggml-cpu的改动让f32的gelu_quick和geglu_quick不再依赖FP16查表,同时保留原有GGML_GELU_QUICK_FP16表路径,并新增VXE gelu_quick路径与f32 CPU kernel测试。
OpenAI推出Patch the Planet,协调开源关键漏洞的披露与响应
OpenAI News称,该项目把安全研究者、开源维护者和事件响应人员连接起来,用于处理开源软件中的关键漏洞。来源未披露上线时间、参与机构数量、具体漏洞案例或运作机制细节。
llama.cpp发布b11784:修复SYCL后端IQ3量化崩溃
该版本由GitHub Actions自动构建发布,更新说明只列出一项改动“Sycl iq3 crash fix (#30604)”,同时提供多平台预编译包下载。
llama.cpp发布b11782:修复n>1 时completion_tokens统计偏低
该版本发布说明中列出的唯一改动是server端usage.completion_tokens在n大于 1 时计数不足的修复(#29486),发布者为ggml-org/llama.cpp,提交说明注明Assisted-by: Copilot。
llama.cpp b11781为server新增POST /tts端点
该版本在server中加入面向TTS模型的POST /tts端点,支持通过form-data上传speaker_ref,并通过API暴露seed。变更由提交者通过PR #26603 说明。
llama.cpp服务器新增实时转写API,WebSocket握手纳入API key校验
llama.cpp发布b11780版本,其server组件加入实时转写API。提交说明称,新接口按GA Realtime规范定义会话结构,并修补了实时槽位占用、会话创建时序和WebSocket鉴权等问题。
llama.cpp b11778发布:新增对Nemotron-3(.5)-Embed模型的支持
llama.cpp发布构建版本b11778,变更说明仅一条:支持Nemotron-3(.5)-Embed(PR #30877),同时提供macOS、Linux、Windows、Android等平台的预编译包。
llama.cpp b11777发布:Qwen输出改为二维重塑并移除末尾reshape
本次构建改动集中在Qwen相关输出整形逻辑:将输出重塑为 2D而非 3D,并移除最后的reshape、修正注释(PR #30823)。发布页同时列出多平台预编译包。

Claude Code v2.1.306修复云会话登录与环境变量问题
Anthropic的Claude Code发布v2.1.306,修复云会话中claude -p未带环境变量启动时报“Not logged in”,以及MCP工具较多时会话的API错误被替换为“prompt is too long”并触发不必要压缩。
llama.cpp b11776修复投机解码下logprobs缺失问题
llama.cpp发布b11776版本,服务器端在投机解码路径中返回logprobs;随附回归测试对比启用草稿与未启用草稿的运行结果,称该测试在未修复的主分支上失败、在修复后通过。
llama.cpp b11774修正LFM2系列视觉模型图像切块与transformers不一致问题
llama.cpp发布b11774,mtmd组件让LFM2系列图像切块直接拉伸到网格、裁切与缩略图尺寸改用Python的round半偶舍入和双精度计算,称在 [1,4096]² 范围内每个尺寸都与transformers对齐。
llama.cpp发布b11772,修复Gemma 4前馈激活函数问题
构建编号b11772对应提交“mtmd: fix gemma 4 ffn act”(#30882),发布页称其为本次修复项;随版本附带的预编译包覆盖macOS、Linux、Windows、Android及Snapdragon平台。
gemini-cli发布v0.67.0每夜版,修复gitconfig保留与MCP OAuth私网端点
该每夜版包含 6 项变更:gsutil迁移至gcloud storage、保留用户级 ~/.gitconfig、修正isAuthenticationError误匹配、允许MCP OAuth选用私有网络端点,以及v0.65.0变更日志和版本号更新。
llama.cpp b11770发布:ggml-cuda支持ssm_conv卷积核尺寸 7
该版本由自动发布账号github-actions[bot] 在GitHub Releases页面发布,构建描述仅一行:ggml-cuda增加对ssm_conv kernel size 7的支持(#30873)。随版本提供macOS、Linux、Windows、Android等多平台预编译包。
Langflow发布 1.12.7,集中修复多项安全与依赖问题
Langflow 1.12.7版本发布,变更清单以安全修复为主,涉及OpenSearch连接器URL校验、S3上传范围、运行时加载能力限制和公开组件构建的权限策略等,另含依赖升级和一项测试。
llama.cpp b11769修复server路由未将客户端断连完整传递到子进程的问题
该版本由GitHub Actions自动发布,合并 #29707:Router此前未能将客户端断连完整传递给子进程,等待响应可能导致取消被延迟;同时移除了对时序敏感的router取消测试。
llama.cpp b11768修复Responses API流式事件缺失output_index
llama.cpp发布b11768版本,服务器端在Responses API的SSE事件中补上output_index字段,以提高与依赖该字段的客户端的兼容性;该修复使用了Anthropic流式代码,并移除了部分工具调用相关字段。
llama.cpp b11767发布:LFM2-VL图像切片参数改从GGUF元数据读取
该项目称,转换LFM2-VL mmproj时会把min_tiles、max_tiles、tile_size和max_pixels_tolerance写入GGUF元数据,clip.cpp读取这些值,缺失时沿用原有常量作为默认值。
python-genai发布v2.32.0:新增Live API会话内上下文更新与generation_output_config
Google的python-genai仓库发布v2.32.0,更新日期标注为 2026 年 10 月 21 日。功能项包括为GenerateContentConfig增加generation_output_config、在GAOS SDK的PromptedVoice中加入base_voice,以及跨各GenAI SDK为Live API增加会话内上下文更新(send_context_update)。
llama.cpp b11765移除Kolibri-1路由器中冗余的精度覆盖
llama.cpp发布b11765版本,合并PR #30865:Kolibri-1路由器矩阵乘法的两处ggml_prec_set_* 精度覆盖被删除,原因是该矩阵乘法使用默认精度即可工作。