

该版本是一次版本号跃升,从发布信息来看同步产出了覆盖macOS、Linux、Windows、Android等多平台的预编译二进制包。
阅读全文开源项目
关注开放的模型、工具与代码,找到值得动手的项目。
本页最新按事件时间排序
llama.cpp b10956为SYCL后端加入大k值radix select,k>32 不再回落CPU
该版本用基数选择替代扫描归并,解决SYCL后端GGML_OP_TOP_K在k大于 32 时被迫退回CPU的限制;qwen4exp稀疏注意力索引器每token在 12 层请求k=2048,此前每次都会触发这一回退。
阅读全文llama.cpp b10955修复ggml-cpu预编译头导致的堆内存损坏
llama.cpp发布b10955构建版本,通过禁用ggml-cpu预编译头并移除CACHE_LINE_SIZE中的std::hardware_destructive_interference_size分支,修复了rope工作缓冲区被少算、堆溢出后崩溃的问题。
阅读全文llama.cpp b10952发布:修复SYCL后端oneDNN scratchpad破坏内存池释放顺序
该版本由github-actions[bot] 发布,主要修复SYCL下oneDNN scratchpad干扰池释放顺序的问题(#28704),并同步更新各平台预编译包。
llama.cpp b10951调整llama_n_rs_seq调用位置以跳过不必要的llama_decode
该提交把llama_n_rs_seq的检查提前到llama_decode之前,命中时直接返回,去掉res赋值和goto语句,发布页同时给出b10951的多平台预编译包。
llama.cpp b10950发布:CUDA后端在不支持BF16的显卡上回退到F32
该版本在ggml-cuda中新增回退逻辑,当设备缺乏BF16硬件加速时改用F32计算;补丁由Johannes Gäßler参与,并同时应用于NVIDIA设备。
llama.cpp b10948发布:WebGPU测试排除HY_V4模型
llama.cpp发布b10948版本,唯一代码变更是将HY_V4从WebGPU架构测试中排除,同时照常提供覆盖macOS、Linux、Windows、Android的多平台预编译包。
llama.cpp修复nemotron-h加载时除零崩溃,改为报告元数据错误
在b10947版本中,针对nemotron-h模型,当predict层的expert_feed_forward_length与n_expert_used同时为 0 时,NextN/MTP尾部循环会触发除零并直接SIGFPE,现在改为报告格式错误的元数据。
llama.cpp发布b10946:修复s390x架构VXE专用重打包辅助函数
该版本标题为「ggml-cpu(s390x): guard VXE-only repack helpers (#28775)」,为IBM s390x平台提供Ubuntu CPU预编译包。
llama.cpp b10944修复SYCL后端显存获取错误
该版本修复了SYCL后端在获取显存信息时的报错,改进了对不支持ZES API的硬件和缺失Level Zero开发包时的处理,并清理了相关调试代码。
llama.cpp发布b10941版本,缩减Flash Attention测试规模
llama.cpp发布b10941构建版本,本次改动为减少FA测试体积(PR #28842),同步提供macOS、Linux、Windows、Android、iOS等多平台二进制包。
涂少坤的Archify登顶GitHub三榜,单日最高新增5000 Star
量子位对话Archify开发者涂少坤:这个把模糊想法画成图表的Agent项目总揽5.88万Star、3.8k Fork,项目与开发者本人同时登上GitHub热榜第一,他目前是小红书AI Native工程师。
llama.cpp b10938为Vulkan后端加互斥锁,绕过英伟达驱动队列提交缺陷
llama.cpp发布b10938版本,主改动是在Vulkan后端为queue submit加互斥锁,原因是同一VkDevice上两个队列同时提交会破坏内部同步,该缺陷来自英伟达驱动、修复前一直保留此变通方案。

LiteLLM发布v1.102.0-rc.1:新增多个OCR适配器与Azure/Vertex Mistral支持
该候选版本把OCR接入Azure Document Intelligence、Azure Mistral、Vertex Mistral、Vertex DeepSeek和Reducto,并加入Claude Code与Codex的网关密钥配置命令。
llama.cpp b10936发布:改进qwen3-coder复杂类型解析
llama.cpp新构建b10936的聊天功能改进了qwen3-coder的复杂类型解析,增强了qwen3解析器的schema支持并清理了语法。
llama.cpp b10935发布:新增LOG_JSON宏记录结构化日志
llama.cpp发布构建b10935,核心变更是common组件新增LOG_JSON宏,用于输出结构化数据,并在fit中加入演示;同时附带了各平台预编译包下载。
llama.cpp b10934重构JSON Schema处理:引入common_chat_schema内部表示
llama.cpp发布b10934构建版本,核心变更是为JSON Schema实现common_schema内部表示,并将json-schema-to-grammar迁移到该表示上。
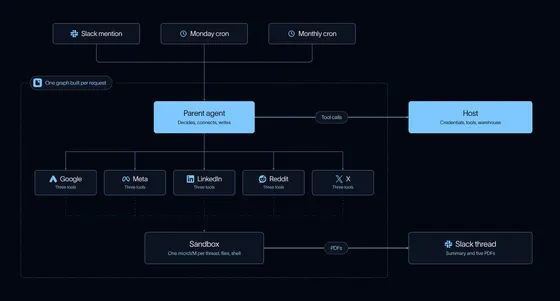
LangChain开源自建付费媒体代理:六个月内付费渠道贡献 20% 营销管道,单次报告成本降 40 倍
LangChain博客披露,其付费媒体代理于每周一汇总各广告平台数据与仓库中的线索和管道,生成摘要和PDF报告;六个月间付费媒体从贡献 0 升至 20% 的营销管道,6 月至 8 月单条合格线索成本降 30%,代理自身的早期报告工作流成本降低约 40 倍、运行时间从 18 分钟降至 85 秒。
llama.cpp b10933发布:Jinja模板支持点属性后接整数字面量
llama.cpp发布b10933版本,唯一列出的改动是修复Jinja模板解析,使其支持点属性后面跟整数字面量的写法(PR #28817)。
llama.cpp b10932修复Clang预编译头时间戳导致的缓存构建失败
ggml-org发布的llama.cpp b10932在cmake中让Clang预编译头不再记录源文件修改时间,解决从其他checkout恢复缓存头后构建报错的问题,同时照例提供多平台预编译包。

Claude Code v2.1.270修复只读git命令误报权限问题
该版本回退了 2.1.269 引入的回归:会话运行一段时间后,Bash中的只读git命令会意外弹出权限确认。
llama.cpp b10930修复模型数量达上限时无法下载模型的问题
该版本针对issue #26809 修复了server在已加载模型数达到上限时不允许下载新模型的限制,并同步发布macOS、Linux、Windows、Android等多平台预编译包。
llama.cpp b10929发布:为AMD GCN架构在HIP后端加专属配置表
llama.cpp发布b10929版本,核心变更是提交 #27841——在ggml-cuda的HIP路径中为AMD GCN架构新增专门的配置表,同时更新了覆盖macOS、Linux、Windows、Android等多平台的预编译产物。
llama.cpp发布b10927:把cpp-httplib升级到 0.56.0
这是一个构建号更新,唯一实质代码改动是vendored的HTTP库cpp-httplib升到 0.56.0(PR #28787),各平台预编译产物随新构建号一并重新生成。
llama.cpp发布b10926,改进对不支持tq1_0量化格式的失败处理
llama.cpp新版本b10926由贡献者syscl提交的 #28681 改动,让程序在遇到不支持的tq1_0量化时优雅失败,而不是异常崩溃。
llama.cpp b10924修复路由子进程状态命令被日志污染的问题
llama.cpp发布b10924构建,修复子进程状态命令与日志共用管道时因颜色重置转义序列导致命令被当作日志转发、已完成下载卡在downloading状态的问题。
llama.cpp发布b10923:修复OpenCL后端多处崩溃
该版本的主要变更是修复OpenCL后端导致程序中止的若干bug,同时照例放出覆盖macOS、Linux、Windows、Android等的预编译包。
llama.cpp发布b10922:为OpenCL加入Q4_K A8二值化GEMM内核
该版本新增kernel_gemm_noshuffle_q4_k_f32_32b_trans_ila_a8_bin,针对非MoE的A8 Q4_K场景,并修正了布局兼容性、重命名了二值内核选择辅助函数。
llama.cpp b10921修复WebGPU块量化张量绑定偏移
llama.cpp发布b10921版本,WebGPU后端将张量绑定偏移回退对齐到类型块大小,使块量化视图在着色器中获得有效元素偏移。
llama.cpp b10920为Hexagon后端加入多设备行切分支持
该版本允许把模型按行切分到多台Hexagon设备上运行,并为此修正了矩阵乘、注意力、ROPE等大量算子的多设备分区逻辑,同时更新了开发者文档和运行脚本。