

该版本允许把模型按行切分到多台Hexagon设备上运行,并为此修正了矩阵乘、注意力、ROPE等大量算子的多设备分区逻辑,同时更新了开发者文档和运行脚本。
阅读全文开源项目
关注开放的模型、工具与代码,找到值得动手的项目。
本页最新按事件时间排序
llama.cpp发布b10919:ggml-webgpu升级到新版Dawn
llama.cpp的b10919版本更新了ggml-webgpu后端所依赖的Dawn版本,并同步提供macOS、Linux、Windows、Android等多平台预编译包。
阅读全文
gemini-cli发布v0.61.0 nightly,修复间接提示注入与沙箱文件系统边界
该nightly版本包含两项安全修复:阻止通过构建文件修改和不可信标志触发的间接提示注入,并加固沙箱文件系统边界、隔离运行时状态。
阅读全文llama.cpp发布b10917:MSVC下跳过llama-server的预编译头
该版本修复了此前引入PCH时在MSVC上引发的问题,关联issue #28758,并同步更新了macOS、Linux、Windows、Android等平台的预编译产物。
GitHub日本韩国市场负责人用Copilot把活动运营写成代码
Tomoko Tanaka在GitHub官方博客披露:把活动立项、报名筛选、会后上传CRM全流程交给GitHub Issue表单、标签触发的Actions和Copilot,过去手工花一两天搭建的活动现在从单个Issue自动跑起来。
LangChain发布langchain-core 1.6.3:可根据网关响应覆盖模型名与提供商追踪元数据
该版本在 1.6.2 基础上新增一项功能:允许基于网关响应覆盖模型名称和提供商的追踪元数据,另有测试和文档清理。
llama.cpp b10909:Metal后端融合表重构,修复约5% token生成性能回退
这次更新把Metal后端所有可融合算子模式集中到一张融合表,同时修掉一个因输出索引用错相对索引、导致norm/MUL融合静默失效并造成约 5% token生成回退的bug。
llama.cpp b10908修复Metal后端IQ矩阵乘内核空转线程
该版本针对ne00=4 的剩余iq mul_mv内核修复空闲线程问题,并整理行切片偏移逻辑;K-quants存在同类问题但需单独改动。
llama.cpp b10907修复deepseek2、glm4moe等架构的MTP上下文KV缓存分配
该版本为deepseek2、glm4moe、cohere2moe架构修复MTP上下文KV缓存分配问题,并加入逆架构门控;同时发布覆盖macOS、Linux、Windows、Android的多平台预编译包。
llama.cpp b10905发布:为RDNA4开启head size 256的MMA Flash Attention
该版本集中在CUDA/HIP的Flash Attention调优,HIP后端在RDNA4(gfx1201)上为head size 256启用mma FA并调整配置;AMD WMMA路径改为优先整块tile的FA网格而非stream-k。

LiteLLM发布v1.102.0-dev.2,新增OCR适配器与按TTFT百分位路由
该开发版仍以cosign签名验证为基础,更新集中在MCP授权、消费追踪、Terraform资源与路由策略等修复和功能上。
RunningHub开源MiniMax H3多卡加速方案,称4卡RTX 6000D生成提速约12倍
量子位报道,一站式AIGC创作平台RunningHub将MiniMax H3的推理加速方案开源至GitHub,称在4张RTX 6000D上生成5秒1344×768视频从348.8秒降至28.7秒,且保留BF16精度。
llama.cpp发布b10901:Vulkan后端在上下文空闲时改用CPU写入
该版本唯一的代码改动是ggml_backend_vk_cpy_tensor_async在上下文空闲时使用CPU写入,同时照例放出各平台预编译包。
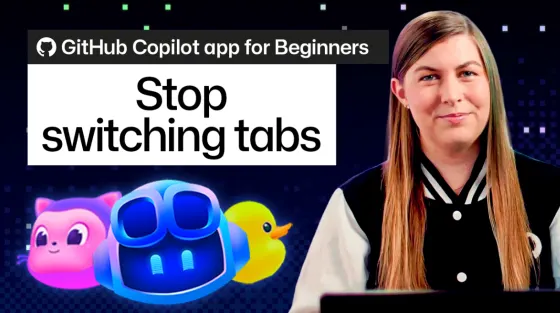
GitHub官方博客介绍Copilot应用内置diff、终端与浏览器面板
GitHub官方博客介绍,GitHub Copilot应用内置diff面板、终端面板和浏览器面板,让审查、运行和预览agent生成的代码在同一应用内完成,无需在编辑器、终端和浏览器之间切换。
Google ADK Python 2.9.0发布:新增模型自动故障转移、LiveKit语音支持与MCP SDK 2.x兼容
ADK 2.9.0引入FallbackModel在主模型出错时自动切换备用模型,新增LiveKit runner用于语音和电话代理,并支持从YAML加载ADK 2.0图工作流;同时带来四项破坏性变更。

OpenAI发布Codex Windows语音版Cygwin构建输入与对应源码
这批归档仅用于CI构建原生Windows语音版Codex,不包含在Codex用户安装包中,包含 103 个固定版本Cygwin二进制包和 83 个对应源码包。
openai-python发布v3.13.0,新增Agents API
OpenAI官方Python SDK于 2026-9-10 发布 3.13.0 版本,更新日志中唯一列出的特性是新增Agents API,对应提交 1c4284a。
LangChain发布langchain-anthropic 1.7.2,修复无效工具调用块丢失问题
该版本距 1.7.1 仅有一处修复:保留无效的tool use块;来源为GitHub Release摘要。
llama.cpp发布b10900:Vulkan后端借add_alloc_dep为预填充启用topk_moe融合
该版本说明(来源仅为发布页摘要)写明唯一改动是Vulkan后端使用add_alloc_dep让topk_moe融合在预填充(prefill)阶段生效(PR #28422),同时照例提供各平台预编译包。
llama.cpp b10899发布:为Qwen优化Vulkan小M矩阵乘法
该版本针对Qwen在Vulkan后端的小M场景做了三项改动:m=1 的mul_mat改为交换A/B、允许小M使用split_k、coopmat2的小/中tile选择改为依赖M而非只看N。
llama.cpp b10897发布:Windows ARM64的CUDA 13构建改用 13.4.1 GA可再发行组件
该版本将Windows ARM64 CUDA 13.4构建从Developer Preview归档迁移到 13.4.1 正式发布(GA)可再发行组件,并同步更新各平台预编译包。

Anthropic Python SDK发布 1.5.0:Managed Agents可挂载公开GitHub仓库
该版本为Managed Agents加入自动模式工具权限、无需authorization_token即可挂载公开GitHub仓库,并新增web_fetch的content_too_large错误码。
OpenAI Python SDK 3.12.0发布:新增Live API,修复异步流清理等问题
OpenAI Python SDK发布 3.12.0 版本,新增Live API;同时修复AsyncStream缺少aclose()、无类型参数的裸dict/list注解处理、以及空响应完成时保留已定稿输出三个问题。
LiteLLM发布v1.100.1,回滚部分支出归因改动
LiteLLM v1.100.1已发布,除回迁两项改动外,还撤销了stable/1.100.x上的支出归因回迁;版本说明同时提醒Docker镜像已用cosign签名。
ONNX Runtime 1.30.0发布:新增Go绑定,CUDA与WebGPU推理能力扩展
微软ONNX Runtime发布 1.30.0 版本,这些说明覆盖自 1.29.1 以来的变更。亮点包括:CUDA推理支持扩展,为连续批处理引入变长因果卷积、paged XQA中的投机解码,以及带per-channel scales的INT4 paged KV cache;WebGPU方面改进PagedAttention、新增GPT-OSS支持与INT8 KV-cache块量化;CPU端新增AVX-512、Arm64 NEON和SVE的融合LinearAttention内核;并新增ONNX Runtime C API的Go绑定与DeepSeek Engram contrib算子。
llama.cpp发布b10896:修复DFlash视觉模型下mtmd chunk解码失败问题
llama.cpp新构建b10896修复了投机解码组件DFlash在搭配视觉模型时,mtmd chunk因图像固定偏移而无法解码的问题,并调整为仅跳过图像、允许音频通过。
llama.cpp发布b10894:清理旧模型中的死分支代码
llama.cpp发布构建b10894,本次唯一代码变更是清理若干旧模型中因早前重构而被复制粘贴、实际上已不可能触发的switch分支。
llama.cpp发布b10893:提高Add融合测试容差
llama.cpp新构建版本b10893的主要代码变更是提高Add融合测试的容差,同时发布覆盖macOS、Linux、Windows、Android及UI的预编译包。
llama.cpp发布b10892:测试代码移除SYCL特殊处理
llama.cpp新构建b10892的唯一代码变更是从test-backend-ops.cpp中删除针对SYCL的特殊分支(PR #28688),同时照常发布各平台预编译包。
llama.cpp为PowerVR显卡增加shared-memory reduction回退路径
Imagination的Vulkan编译器对要求subgroup size ≥16 的反量化mul_mat_vec shader一律返回VK_ERROR_UNKNOWN,导致k-quants、i-quants、TQ2_0、MXFP4、NVFP4模型在生成第一个token时进程崩溃。新版本在PowerVR上改走shared-memory reduction。