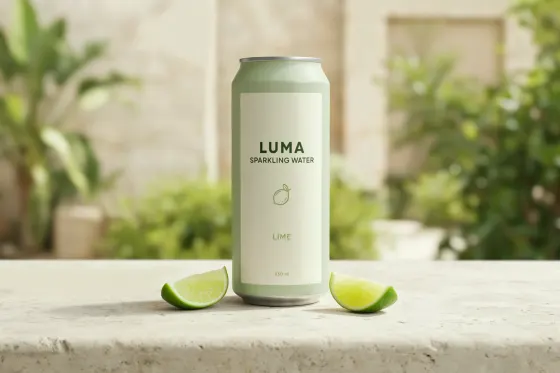
该博客以虚构气泡水品牌LUMA的罐身为演示,展示品牌名、品类、口味、容量四项文字在换色和换景后仍可辨认;文中的效果来自Ideogram自行组织的测试,不能视为各平台的公开评测结论。
阅读全文追踪模型的新能力,理解每一次迭代带来的变化。
该博客以虚构气泡水品牌LUMA的罐身为演示,展示品牌名、品类、口味、容量四项文字在换色和换景后仍可辨认;文中的效果来自Ideogram自行组织的测试,不能视为各平台的公开评测结论。
阅读全文Ideogram在自家博客发布商用图像生成平台评估清单,逐条列出Ideogram、Adobe Firefly、Getty Images、Bria、OpenAI与Google Cloud的赔偿范围、数据控制与自托管条件,并提醒消费端订阅与企业协议不可混用。
阅读全文Ideogram在自家博客发布对比文章,列出八家平台在品牌一致性上的适配场景与定制方式,并披露其Custom Branded Models的自助训练要求:15–100 张图像、标准训练消耗 4,000 credits。
阅读全文OpenAI表示,Dan Driscoll将就负责任AI在国家安全现代化、网络韧性和美国盟友合作中的使用提供建议。
据OpenAI News报道,Qodo将公司知识和编码规范带入Codex,帮助开发者在发起拉取请求前跨仓库识别P0级问题。该描述来自OpenAI的发布信息。
硅基流动在官方博客中介绍,DeepSeek V4 Pro提供Low、High、Max三档推理级别,建议按任务风险而非习惯选择档位:Low用于日常编辑类任务,High覆盖多数多步骤工作,Max用于处理含糊的失败情况。

AWS博客作者Aswath Ram A Srinivasan提出覆盖归因、可观测、预算强制、默认优化和定期复盘的闭环,面向FinOps与平台工程团队,并给出IAM会话标签、请求元数据和网关拦截等具体做法。

在智元创新日上,联合创始人彭志辉(稚晖君)发布具身基座模型GO-3 Preview和交互大模型WITA-OMNI,并推出衡量机器人有效智能工时的单位Worken。智元称GO-3 Preview在三项具身智能评测居首,WITA-OMNI在四项评测登顶。
OpenAI表示,将遵循一个共享的robots.txt信号,帮助网站运营者向参与该机制的提供商表达其AI训练偏好。
据OpenAI新闻稿,该公司称正通过扩展防护措施和更早的干预来加强ChatGPT的暴力预防,并承诺开展公共安全报告;来源未披露具体机制、生效时间、适用地区或效果数据。
这份来自Ideogram官方博客的清单按直接API、云平台和推理平台三类比较十家图像生成服务,并提示同一模型经不同平台调用时,请求结构、价格、存储策略和商业条款可能不同。文中能力与价格多为各方文档自述,部分项目标注为“未确认”。
Ideogram在自家博客列出 8 个创意自动化平台并给出对比表与演示提问清单,同时用虚构品牌NORTHLINE演示Ad Resizer把一张方形广告改为竖版信息流、Story/Reel和 970×250 广告牌三种尺寸。
OpenAI在其官网发布创作者、学者、无障碍倡导者和法律专家等提交的法庭意见书摘录,称这些材料说明合理使用制度支持AI训练与创新。
OpenAI新闻页称,新版Model Spec以五项核心价值引导能力更强的AI做出合理判断、尊重人的能动性并忠实于人类意图。来源未披露五项价值的具体内容、执行方式与生效时间。
Mistral称Mistral Large 4可在企业或政府自有环境中下载部署,并称其在网络安全任务上与GLM-5.3性能相当、每任务少用47%的token;上述性能与效率说法均来自公司。

OpenAI在其官方文章《How we detect frontier model misalignment》中说明,公司采用分层监控来发现前沿模型的失准和未经授权的代理行为,以便响应人员在事件升级前介入。
据OpenAI新闻页面介绍,律所Ropes & Gray正与OpenAI合作开发用于交易尽职调查的AI工具;页面称律师会先审阅分组后的文件、摘要和报告,再向客户提供咨询。
该模型在终端工程、长上下文与漏洞修复等多项基准上超过Claude Opus 5.5和GPT-6 Astra,但FrontierSWE 2、OSWorld-2.1及Coding Agent专项仍落后;首发定价为每百万Token输入2美元、输出10美元。
OpenAI新闻页面称,Credit Saison的ChatGPT Enterprise试点实现954%的投资回报率,并称该公司据此推动全员采用。
Carbon在Artificial Analysis Intelligence Index v5上得59分,高于Argon的50分;因强化安全能力,首批仅向选定网络安全专家开放,定价与Argon相同。

Google AI官方博客称,Gemini应用新增一组可交互、可视化的“沉浸式探索”场景,用户可从微观系统逐层查看至深空;该功能目前通过Gemini学生中心进入,之后将可直接在聊天会话中使用。

Google AI官方博客介绍新一代前沿模型Gemini 4 Carbon,作者Koray Kavukcuoglu称其为公司最强模型,在网络安全与长程任务两方面达到最先进水平;来源未公布基准测试、参数、开放范围与时间。

OpenAI新闻页发布一篇题为《公司的未来》的内容,摘要将其主题概括为AI可能以“在我们之下、在我们身旁、在我们之间”三种位置进入组织架构。来源未披露具体模型、客户案例或效果数据。
Genie 4于周二以研究预览形式向“可信测试者”开放,可生成与场景匹配的音乐、环境音和交互对话,并支持在模拟过程中输入文字改天气、换机位或添人物;场景一致性最长维持两分钟,为前代的两倍。

DeepMind称Genie 4可实时生成画面、环境音与人声对话,并能用自然语言中途改变天气、调整机位或加入人物;该模型尚未公开发布,先在Project Genie、Gemini API和AI Studio向受信任测试者开放。
Google称Genie 4生成的世界更真实、支持自然语言实时更新并新增音频生成,单次体验时长从Genie 3的一分钟延长到约两分钟;该模型先以“研究预览”形式向受信任测试者开放。

谷歌官方博客称,Gemini 4 Argon是该公司“最智能的模型”,可处理长周期任务并调用工具;文章展示的 8 个案例均为谷歌自身的演示,未披露独立评测或量化效果数据。

量子位报道,OpenAI于2026年10月27日推出GPT-6.1 Terra,标准API输入1美元/百万Token、输出5美元/百万Token;官方称其在Agents’ Last Exam中表现追平GPT-6 Astra而Token价格为后者十分之一。Plus、Pro、Enterprise、Edu用户可在ChatGPT Work与Codex中体验。
Anthropic表示过去数月与六家机构开展药物研发合作,并收购一家一人公司启动自有项目;相关研究大多处于临床前阶段,公司称部分项目若进展顺利,最早可能在2028年底进入人体临床试验。

据OpenAI News发布的案例介绍,Greptile使用GPT-6 Astra测试用户工作流,用Daybreak加强安全,用Codex减少返工。来源仅提供概述,未给出效果数据。